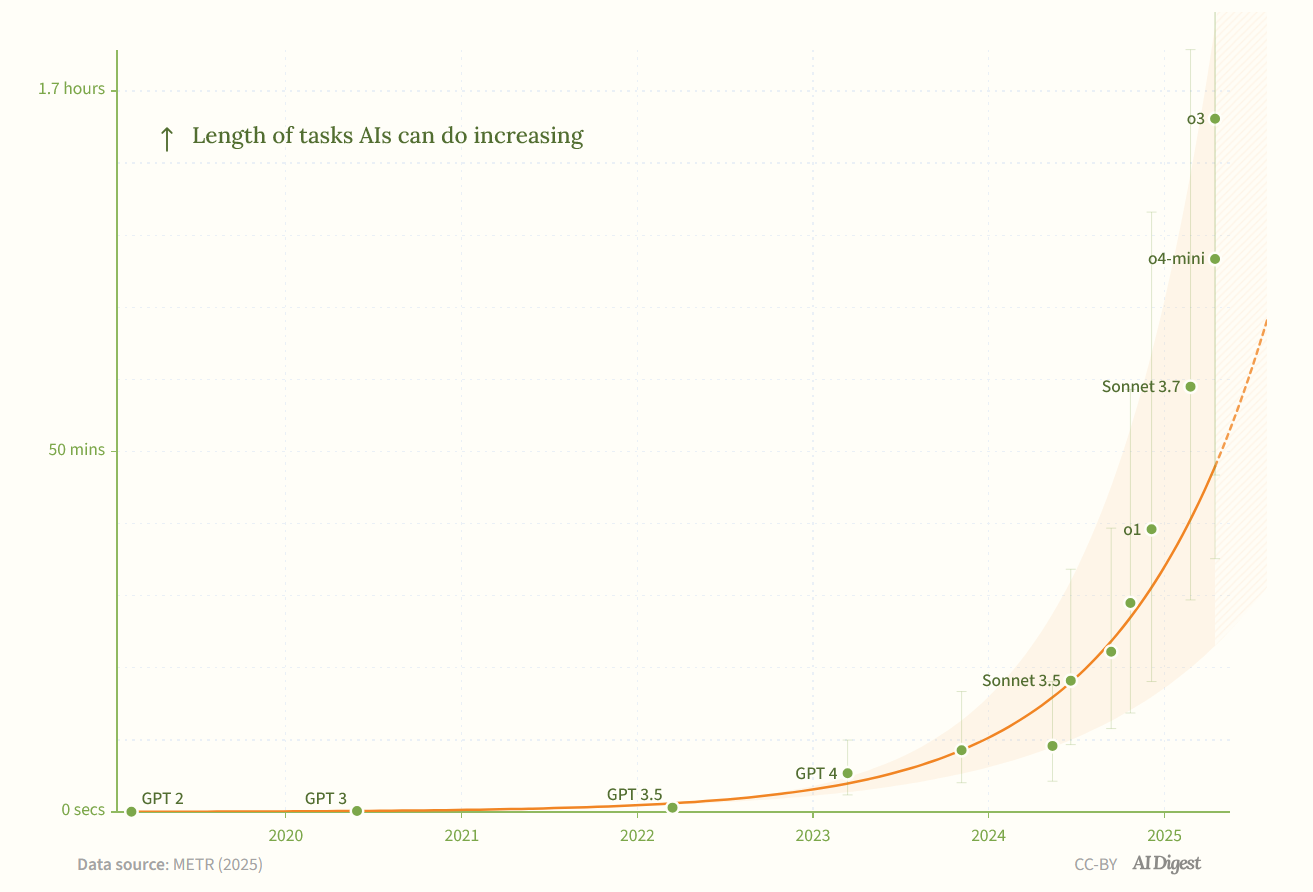
Performance actuelle des LLM : 1 heure

Le METR (Model Evaluation and Testing for Reliability), organisation dédiée à l’évaluation des modèles d’intelligence artificielle, vient de publier un article synthétisant des recherches vraiment intéressantes. L'objectif était de mesurer l'évolution des capacités des LLM (Large Language Model, les modèles de language qu'on retrouve par exemple dans chatGPT)

Lire la suite

Le paradoxe des gros modèles de langages

Il y a quelques semaines, Algorithmic Simplicity a publié une vidéo s’intéressant à un étrange paradoxe : plus un modèle est gros, moins il devrait être capable de généraliser, et ce n'est pourtant pas ce qu'on constate.

D'abord, pourquoi un modèle gros devrait-il être moins bon ? C'est peut être ça qui vous paraitra paradoxal. Eh bien, si un modèle possède beaucoup de paramètres, il peut "apprendre par cœur" ses données d'entraînement sans trouver de liens entre elles. C'est un peu comme si un élève avait un cerveau assez gros pour tout mémoriser, sans faire de liens entre ses connaissances. Un tel modèle serait excellent lors de l'entraînement mais incapable de généraliser quand on lui donne de nouvelles données. C'est ce qu'on appelle l'overfitting.

Lire la suite

Les IA qui apprennent un peu comme des élèves

Andrej Karpathy (1) a publié il y a quelques mois une longue vidéo (3 heures 30 !) sur le fonctionnement des modèles de langage tels que chatGPT (LLM : large language model). Au cours de cette vidéo, il utilise une analogie, que je trouve parlante, sur les différents types d'apprentissage de ces modèles : apprendre pour une IA, ce serait un peu comme apprendre pour un élève :

1) Lire le cours
C’est la première phase : le pré-entraînement. L’IA "lit" des tonnes de textes (livres, sites universitaires, encyclopédies, etc.). Elle apprend à reconnaître des structures, des phrases, des concepts. Comme un élève qui lit son manuel pour se familiariser avec les bases. A cette étape, elle ne fait qu' "ingurgiter" l'information lue.
Bien sûr, analogie oblige, ce vocabulaire est très anthropomorphique et il serait plus correct de dire qu'à cette étape, on cherche un programme capable de prédire le mot suivant lorsqu'on lui donne un début de texte, ce qui nécessite d'encoder des régularités statistiques dans les structures, les phrases, les concepts. J'ai fait une animation pour bien comprendre ce qui se passe dans cette phase de "pre-training", vous la trouverez ici : https://espritcritique.fbfb.eu/fonctionnementLLM/
A l'issue de cette étape, un modèle de langage est presque inutilisable. Il a ingurgité les données mais ne saurait pas les "communiquer". Par exemple, il risque de prédire que le texte qui vient à la suite d'une question est une autre question car, dans ses données d'entrainement, les questions viennent souvent par listes. Il faut donc passer à la deuxième étape.

Lire la suite

Quand les IA génératives sont-elles utiles ? (P versus NP ?!)
Les IA génératives sont impressionnantes, mais on sent que leur utilité varie selon les contextes. Une première idée serait de ne les utiliser que dans les domaines dans lesquels on est expert. Mais il me semble que, plus précisément, les IA  génératives sont utiles dans les situations où vérifier est plus simple que produire. Écrire … Lire la suite

République et canton de Genève | DIP connexion |